De tareas de Fargate a un pool de EC2 hibernado
Caso de estudioAWSUna plataforma que ejecuta eventos en directo a gran escala — webinars entre ellos, junto a lanzamientos de producto, asambleas y espectáculos en directo — ya había trasladado su cómputo por evento a AWS Fargate. Esa arquitectura funcionaba, pero la carga de trabajo que ejecutaba cada tarea, un navegador capturando una llamada más un pipeline de FFmpeg para trocearla de cara a su distribución, era lo bastante pesada como para que el precio por tarea de Fargate dejara de ser la forma más barata de ejecutarla.
Contexto
La plataforma de este cliente ya funcionaba sobre la arquitectura elástica basada en Fargate y Lambda descrita en un caso de estudio anterior: un pool de tareas de Fargate, lanzadas y desmontadas por evento, orquestadas por funciones Lambda que reaccionaban a la demanda en lugar de un servicio de control siempre activo. Aquella migración ya había resuelto el problema de pagar por capacidad ociosa.
Lo que no había resuelto era el coste de la propia carga de trabajo, una vez que el cómputo por evento de la plataforma creció más allá de lo que necesitaba el caso de los webinars original: cada unidad de trabajo ejecutaba ahora un navegador completo para capturar la salida compuesta de una llamada en directo, más un pipeline basado en FFmpeg para trocear esa salida de cara a su distribución. Ninguna de las dos piezas es pequeña ni barata de ejecutar, y el precio por tarea de Fargate añade su propio margen sobre el cómputo subyacente, un margen que pesa más cuanto más pesada es la propia tarea. Ejecutar la misma carga de trabajo directamente en instancias EC2, en lugar de como tareas de Fargate, costaría menos para una carga de trabajo de este tamaño.
El proyecto
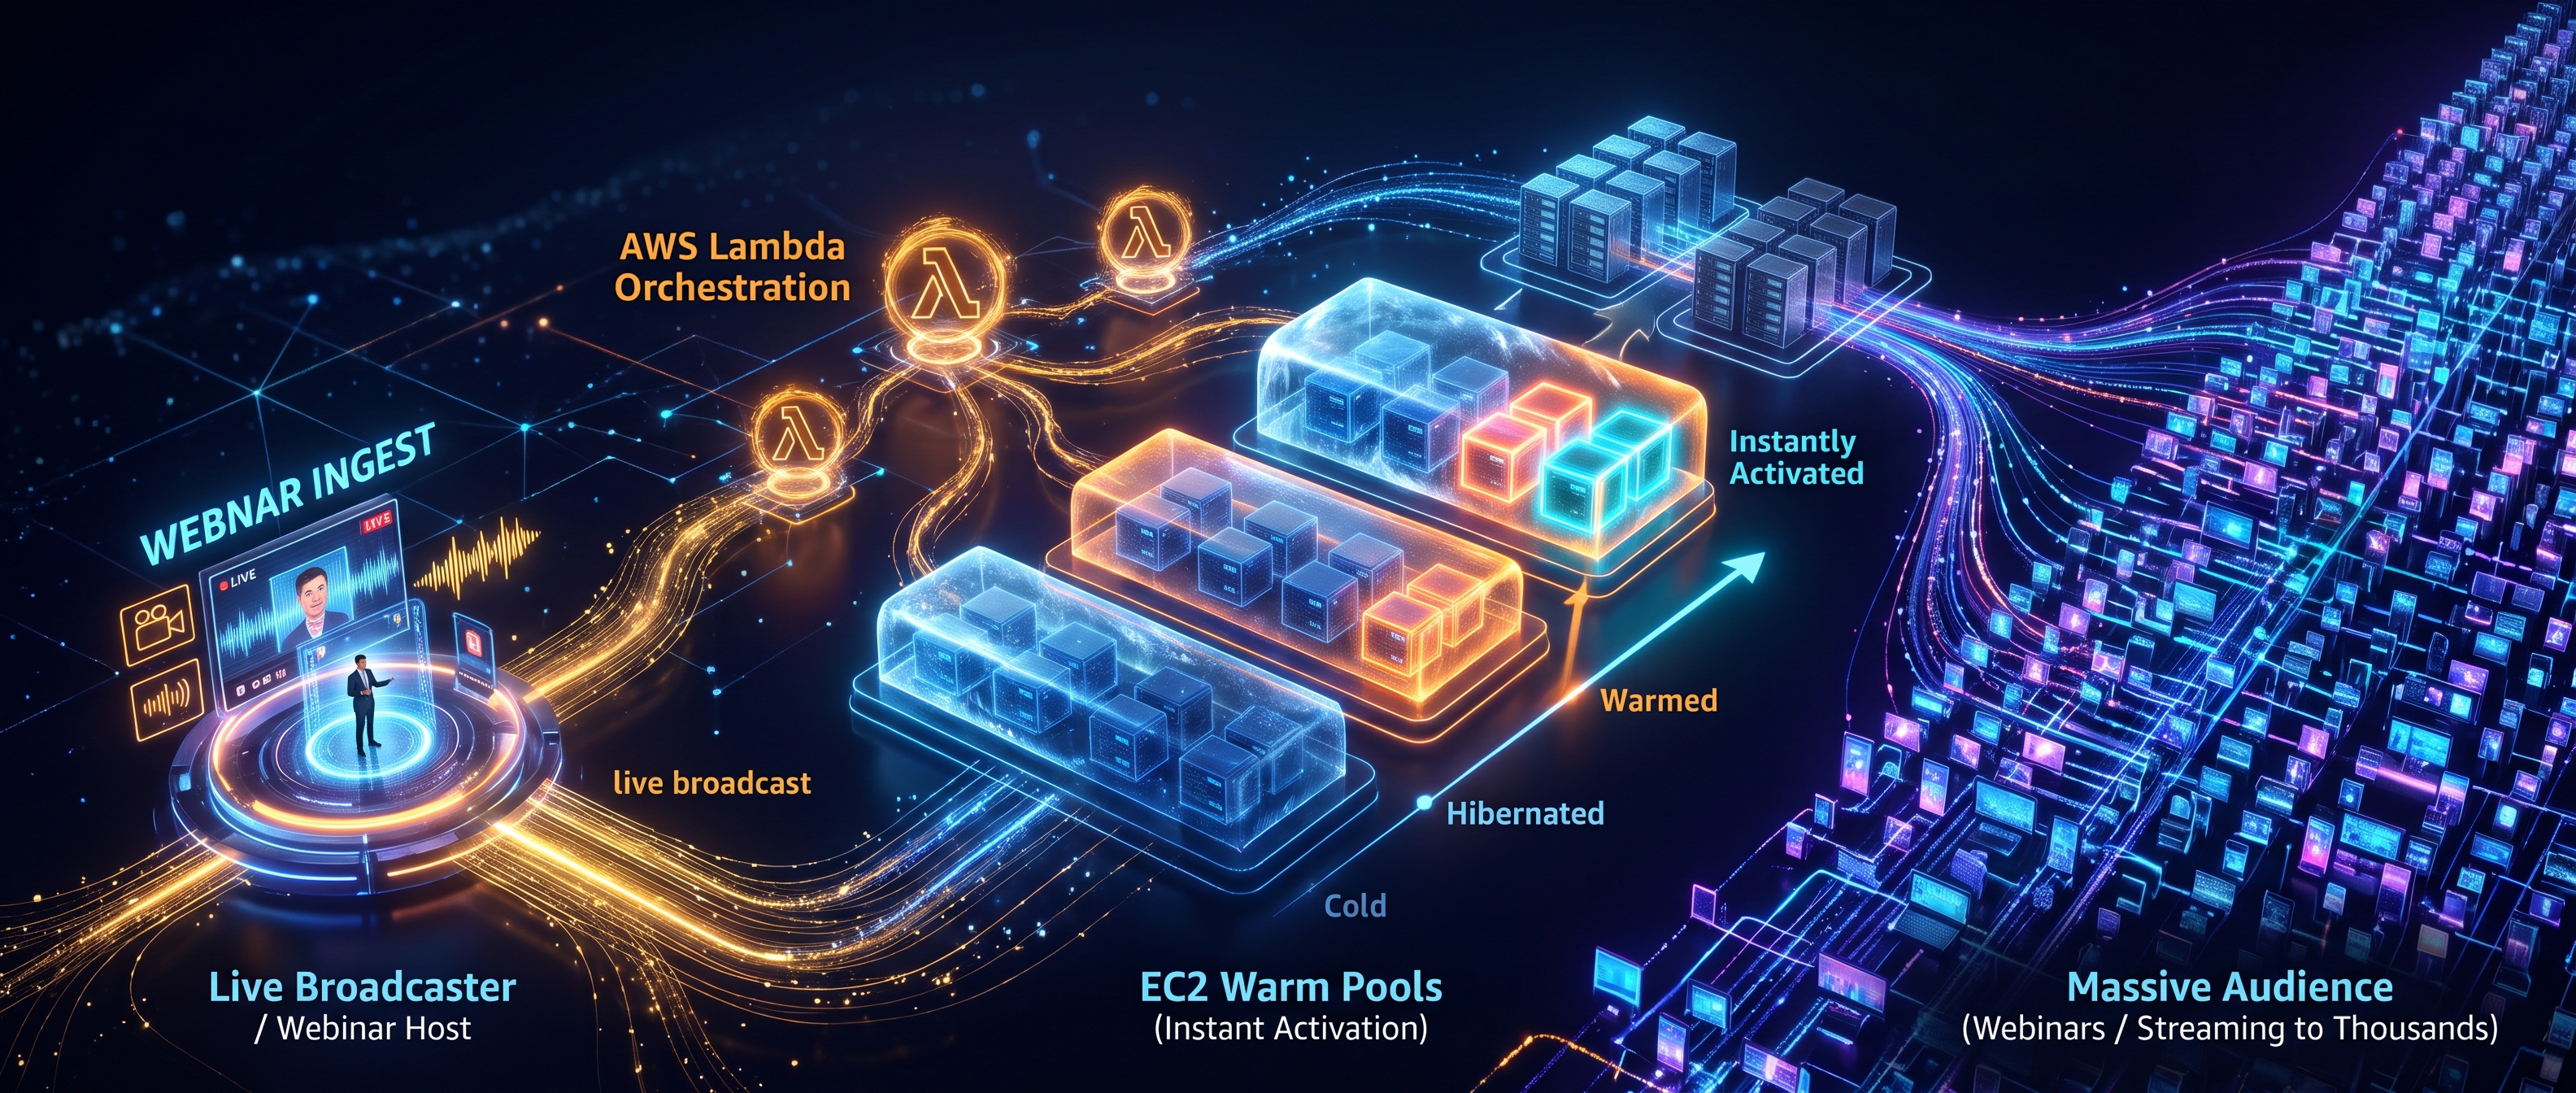
El obstáculo era el arranque en frío. Arrancar una instancia EC2 nueva desde cero, cargar su AMI y levantar la aplicación es mucho más lento que lanzar una nueva tarea de Fargate, demasiado lento para un cómputo que tiene que estar listo en el instante en que arranca un evento. Las instancias EC2 hibernadas cierran esa brecha: reanudar una desde hibernación lleva entre 4 y 10 segundos, lo bastante rápido como para pasar desapercibido dentro del tiempo normal de arranque de un evento.
Eso solo funciona con un pool de instancias ya hibernadas y listas para reanudarse bajo demanda, y el equipo ya entendía de pools: el pool de tareas de Fargate de la migración anterior tenía sus propios requisitos de lanzamiento por lotes de muchas tareas a la vez para absorber picos de demanda, y ese mismo modelo encajó de forma directa sobre un pool de instancias EC2 hibernadas. Gestionar ese pool resultó ser la parte fácil, una vez planteado así: los Auto Scaling Groups de EC2 ya soportan de forma nativa pools de instancias hibernadas, así que la flota escala de forma eficiente usando la propia lógica de autoescalado de AWS, en lugar de un gestor de pool personalizado construido y mantenido internamente, como lo había sido el pool de tareas de Fargate.
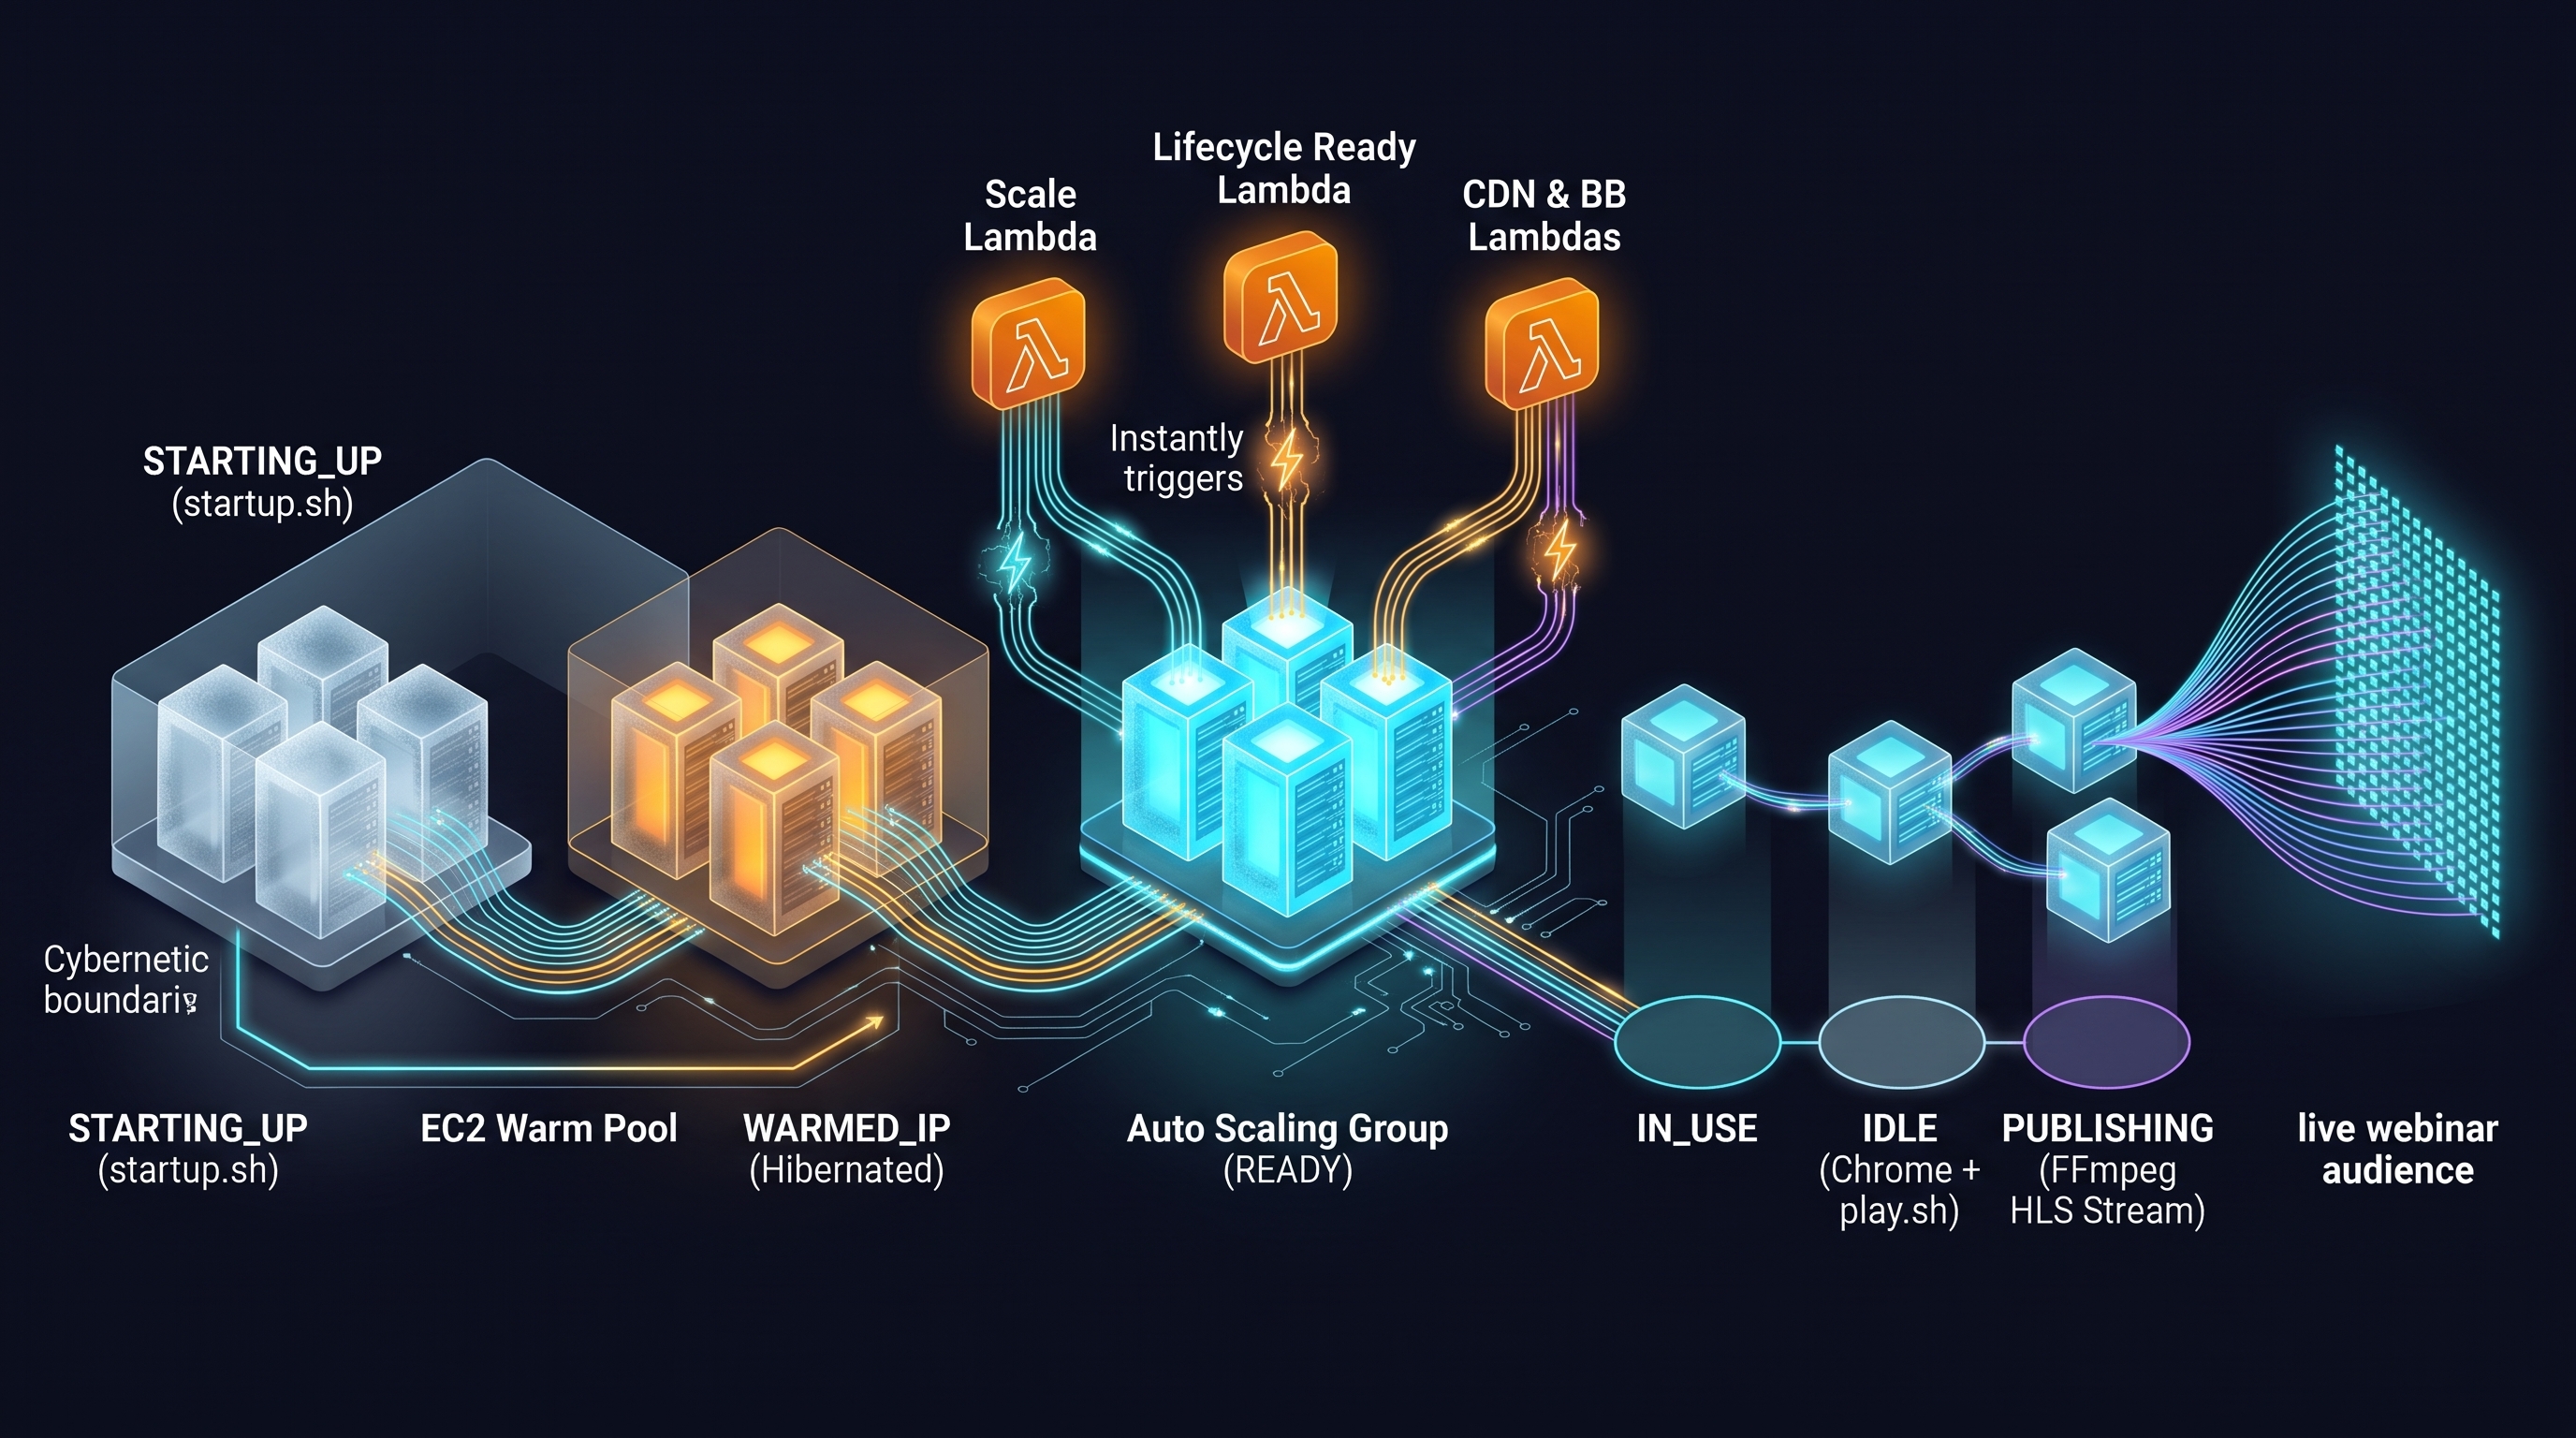
Cada instancia sigue un ciclo de vida con sus propios estados. Una instancia nueva ejecuta su
script startup.sh mientras está en STARTING_UP, pasa a WARMED_IP en cuanto se hiberna
dentro del pool de EC2, y se reclama como READY en el instante en que el Auto Scaling Group
la necesita, un traspaso que una Scale Lambda y una Lambda dedicada de ciclo de vida
disparan al instante en lugar de comprobarlo por sondeo. A partir de ahí la instancia pasa
por IN_USE, IDLE (con Chrome ya en marcha, dirigido por un script play.sh, esperando
para unirse a la llamada) y PUBLISHING, donde FFmpeg codifica la llamada compuesta en un
stream HLS, con un conjunto adicional de Lambdas encargadas de la distribución por CDN y del
mantenimiento del almacenamiento alrededor de lo publicado.
La parte genuinamente difícil fue algo que el modelo de Fargate nunca había tenido que considerar: hacer que cada instancia fuera efímera. Cada instancia del pool se usa para exactamente una sesión y nunca se reutiliza. Devolver una instancia usada a un estado fiable y listo, cerrar el navegador de forma limpia, eliminar lo que hubiera dejado el pipeline de FFmpeg, confirmar que no queda ningún resto, resultó más complejo y no más rápido que simplemente terminarla y sustituirla por una instancia nueva a partir de la misma AMI. Tratar cada instancia como de un solo uso eliminó toda una categoría de estado de la que preocuparse, a cambio de depender de que el pool se reponga por su cuenta con instancias nuevas y limpias tan rápido como se descartan las usadas.
Nuestro papel
- Identificar que el precio por tarea de Fargate ya no encajaba con una carga de trabajo tan pesada, y diseñar el paso a instancias EC2 directas.
- Diseñar el pool de EC2 hibernado que cerró la brecha del arranque en frío, apoyándose en los requisitos de lanzamiento por lotes ya establecidos por el pool de tareas de Fargate anterior.
- Adoptar Auto Scaling Groups de EC2 con soporte nativo de warm pools para gestionar la flota, en lugar de un gestor de pool construido a medida.
- Diseñar el propio ciclo de vida de las instancias (
STARTING_UP,WARMED_IP,READY,IN_USE,IDLE,PUBLISHING) y las funciones Lambda que disparan cada transición. - Diseñar el modelo de instancias efímeras: ninguna instancia se reutiliza nunca entre sesiones, ya que descartarla y sustituirla es más simple y no más lento que limpiarla in situ.
Tecnologías
- Auto Scaling Groups de EC2 con warm pools, para gestionar una flota de instancias hibernadas y pre-arrancadas.
- AWS Lambda, para la orquestación basada en eventos heredada de la arquitectura anterior basada en Fargate.
- AMIs personalizadas, preparadas con Chrome y el stack de FFmpeg que necesita cada sesión.
- Hibernación de EC2, para devolver una instancia de parada a en marcha en segundos en lugar de minutos.
Conclusión y lecciones aprendidas
La comodidad de Fargate tiene un precio, y ese precio deja de merecer la pena en cuanto una carga de trabajo es lo bastante pesada por sí sola. El paso a instancias EC2 salió tan bien como salió porque el pensamiento basado en pools de la migración anterior a Fargate se trasladó de forma directa; la hibernación y los Auto Scaling Groups convirtieron «un pool de cómputo listo» en algo que la propia AWS gestiona bien, en lugar de algo que reconstruir desde cero. Lo que más llamó la atención fue lo claramente que se resolvió el dilema de las instancias efímeras en cuanto se planteó como comparación: limpiar no sale en realidad más barato que empezar de cero. Este proyecto es el origen real de lo que hoy llamamos ERTSA, nuestra Arquitectura Serverless Elástica en Tiempo Real.